以高速、稳定的数据供给持续释放GPU算力,帮助企业构建更高性能、更高效率、更优 TCO 的高速 AI 数据底座。
9 月 22 日,2026 英特尔技术创新与产业生态大会(Intel Connection 2026)在苏州举行。会上,焱融科技联合英特尔正式发布新一代全闪 AI 存储一体机 F9000X Turbo。作为面向大规模AI核心工作负载打造的高性能数据底座,该产品在性能、容量密度与成本效率方面全面升级,以高速、稳定的数据供给持续释放GPU算力,帮助企业构建更高性能、更高效率、更优 TCO 的高速 AI 数据底座。
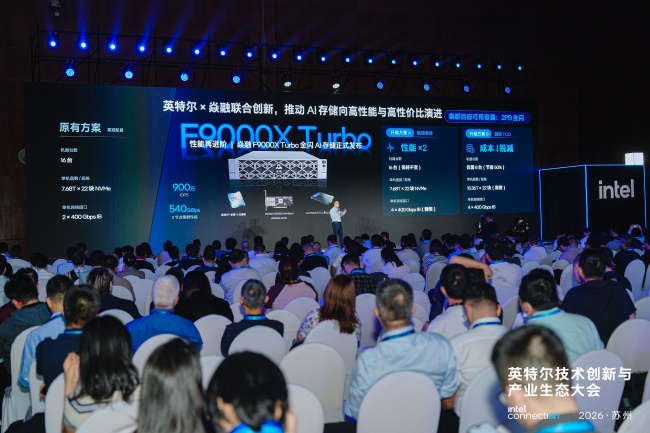
焱融科技 CTO 张文涛现场揭晓 F9000X Turbo
软硬件协同升级,3 节点实现 540 GiB/s 带宽和 900 万 IOPS 强悍性能
F9000X Turbo 是焱融科技与英特尔在 AI 数据基础设施领域联合创新的重磅成果。其延续焱融面向 AI 场景打造的高性能分布式 AI 原生存储架构,并对关键硬件平台进行升级。
根据焱融披露的信息,F9000X Turbo 搭载第 6 代英特尔® 至强® 处理器平台,结合 PCIe 5.0 NVMe 全闪介质,并具备 400Gbps InfiniBand / RoCE 高速网络扩展能力。
在软硬件协同优化下,F9000X Turbo 仅需 3 节点集群即可实现 540 GiB/s 聚合带宽和 900 万 IOPS 的极致性能,充分满足AI核心工作负载对高吞吐、高并发数据访问的需求,高效支撑海量小文件访问、大规模Checkpoint高速读写及海量张量数据供给。
更少节点实现更强存力,大幅优化 AI 基础设施 TCO
在大规模AI基础设施建设中,性能是基础门槛;但随着集群规模扩张,服务器数量、机柜占用、网络布线等综合投入同步增长,如何在保障性能的同时优化整体成本,成为客户越来越关注的因素。围绕不同业务诉求,F9000X Turbo提供了更灵活的部署选择,实现性能与总体拥有成本的双向平衡。
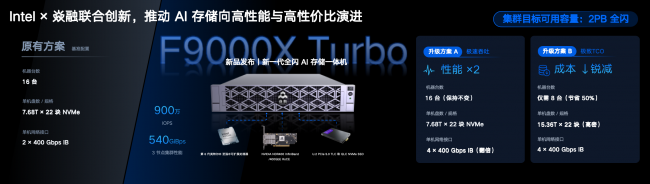
以建设2PB全闪可用容量为例,上一代全闪方案单机配置 22 块 7.68TB NVMe SSD 以及 2 块 400Gbps IB 网卡,需要 16 台设备。基于 F9000X Turbo 可选择两种升级路径:
• 追求更高性能:在保持设备规模不变的情况下,依托更高规格的单机网络能力与系统优化,性能相较上一代方案提升 2 倍; • 追求更优 TCO:在满足同等容量与性能需求的前提下,采用 15.36TB 高密度 NVMe SSD,将原方案所需 16 台设备缩减至 8 台,节点数量减少 50%。
更高的单节点容量与性能密度,帮助企业用更少硬件完成同等数据承载,同步缩减机柜空间、网络端口投入,降低设备功耗与运维压力,提升 AI 基础设施整体投入产出比。F9000X Turbo 的升级不止追求性能提速,更着重提升单设备、单位空间下的有效存力输出。
MLPerf Storage v3.0 多项成绩位居全球第一
F9000X Turbo 的性能表现也在最新一轮 MLPerf Storage v3.0 基准测试中得到验证。
在 Intel Connection 2026 主会场,英特尔数据中心事业部副总裁、中国区总经理陈葆立在主题演讲中展示了 F9000X Turbo 在 MLPerf Storage v3.0 中的测试表现,其在 Llama 3-70B Checkpoint、3D U-Net 等 AI 工作负载测试中取得多项第一。
其中,F9000X Turbo 三节点集群在 3D U-Net 场景下实现 544 GiB/s 聚合读带宽。焱融表示,这是其全闪 AI 存储继 2024 年、2025 年之后,连续第三年在 MLPerf Storage 测试刷新世界纪录。
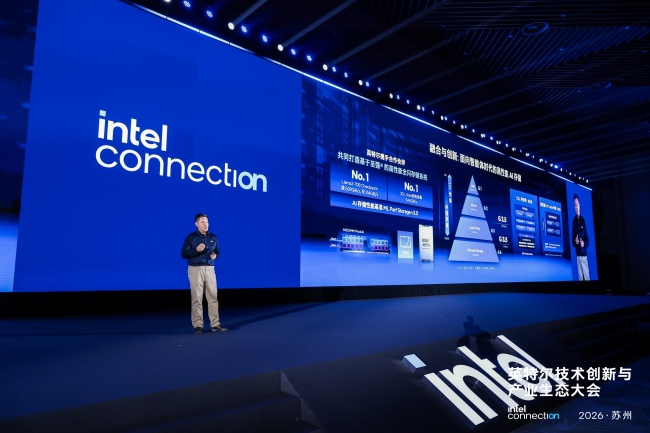
英特尔数据中心事业部副总裁、中国区总经理陈葆立,展示 F9000X Turbo 的 MLPerf Storage v3.0 成绩
从单节点性能优化到集群级效率提升,焱融近年来持续围绕自研分布式存储软件、高速网络、存储介质及硬件平台进行协同优化,提升面向 AI 工作负载的数据供给效率。
携手生态伙伴,加速大规模 AI 产业落地
从更高吞吐、更高IOPS,到更高容量密度与更优TCO,本次 F9000X Turbo 的推出,是焱融全闪 AI 存储产品的一次全面迭代,也是企业夯实 AI 高性能数据底座能力的重要一步。
焱融科技表示,未来将继续深化与英特尔等产业伙伴的合作,面向大模型训练、推理等各类 AI 核心场景持续开展存储技术创新,以高性能、高性价比的存力基础设施释放 GPU 价值,助推国内大规模 AI 产业落地发展。
声明: 此文观点不代表本站立场;转载须要保留原文链接;版权疑问请联系我们。